
فرض کنید برای یک فروشگاه آنلاین جدول محصول طراحی کردهاید. کیبورد رنگ و نوع سوئیچ دارد، هدفون نوع اتصال و مدت شارژ، کتاب ناشر و تعداد صفحه. یا برای هر ویژگی یک ستون اضافه میکنید که در بیشتر ردیفها خالی میماند، یا یک جدول ویژگی جدا با چند JOIN میسازید. هر بار هم که تیم محصول یک فیلد تازه بخواهد، باید migration بنویسید.
MongoDB برای همین نوع داده ساخته شده است. هر محصول یک سند JSONمانند است و هر سند فقط فیلدهای خودش را دارد. در این راهنما توضیح میدهیم MongoDB چیست، داده را چطور نگه میدارد، کجا از MySQL و PostgreSQL بهتر جواب میدهد و کجا نه، و با چند دستور واقعی از mongosh و پایتون و Node.js به آن وصل میشویم.
MongoDB چیست؟
MongoDB یک دیتابیس NoSQL از نوع سندمحور (document database) است. داده را بهجای ردیفهای جدول، بهشکل سند ذخیره میکند. هر سند مجموعهای از جفتهای فیلد و مقدار است، شبیه یک آبجکت JSON، و مقدار هر فیلد میتواند عدد، رشته، تاریخ، آرایه یا حتی یک سند تو در تو باشد.
MongoDB این اسناد را روی دیسک با فرمت BSON نگه میدارد؛ نسخهٔ باینری JSON که نوعهای بیشتری مثل تاریخ، ObjectId و Decimal128 را پشتیبانی میکند. هر سند یک فیلد _id یکتا دارد که اگر خودتان مقدارش را ندهید، MongoDB یک ObjectId برایش میسازد. جزئیات مدل سند را در مستندات رسمی MongoDB ببینید.
اگر با دستهبندی دیتابیسها آشنا نیستید، اول مقالههای دیتابیس NoSQL چیست و انواع پایگاه داده را بخوانید. MongoDB شناختهشدهترین عضو خانوادهٔ سندمحور است و حرف M در پشتهٔ MERN هم از نام آن میآید.
سند، کالکشن و دیتابیس؛ معادلها در دنیای SQL
سادهترین راه برای فهمیدن اینکه MongoDB چیست، مقایسهٔ واژههایش با SQL است. اگر قبلاً با MySQL کار کردهاید، این جدول کمک میکند واژهها را سریع جا بیندازید:
| MySQL / PostgreSQL | MongoDB | توضیح |
|---|---|---|
| Database | Database | ظرف اصلی؛ یک سرور میتواند چند دیتابیس داشته باشد |
| Table | Collection | مجموعهای از اسناد؛ لازم نیست همه ساختار یکسان داشته باشند |
| Row | Document | یک رکورد با فیلدهای خودش، از جمله آرایه و سند تو در تو |
| Column | Field | کلید داخل سند؛ میتواند در یک سند باشد و در سند دیگر نباشد |
| Primary key | _id |
در هر کالکشن یکتاست و خودکار ایندکس میشود |
| JOIN | Embedding یا $lookup |
دادهٔ مرتبط را داخل سند میگذارید یا در aggregation به هم وصل میکنید |
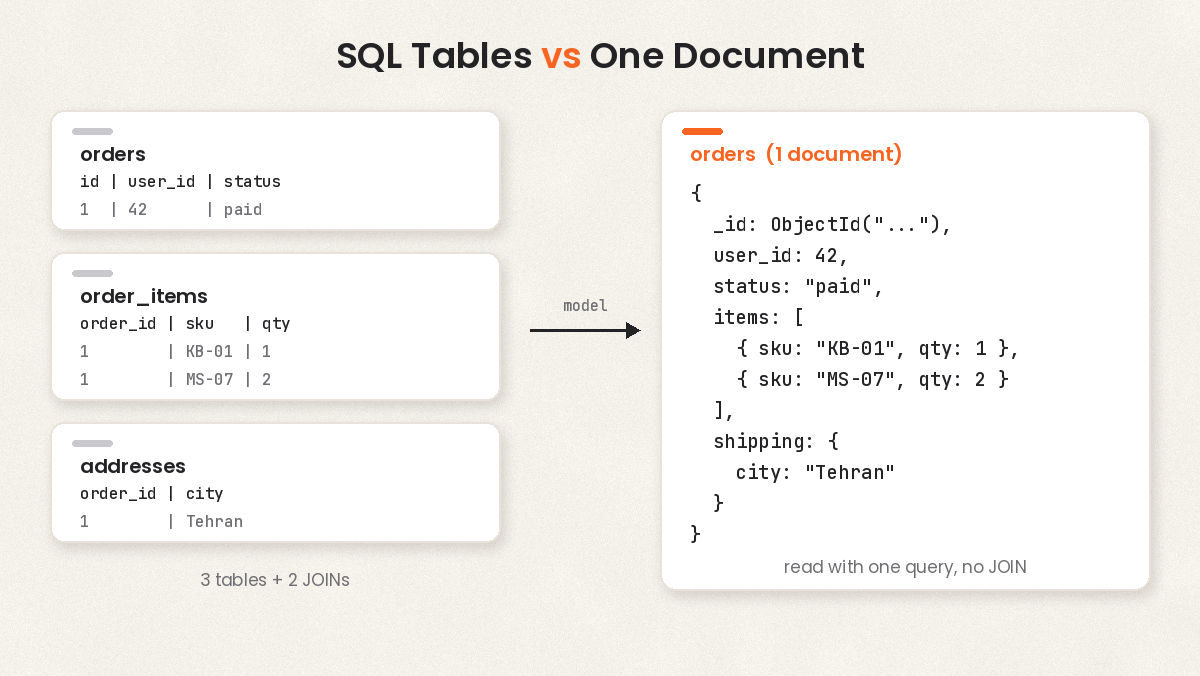
تفاوت اصلی در طراحی است. در SQL سفارش، آیتمهای سفارش و آدرس ارسال معمولاً سه جدول جدا هستند. در MongoDB اغلب همهٔ آنها داخل یک سند سفارش قرار میگیرند، چون همیشه با هم خوانده میشوند. یک کوئری، یک سند، بدون JOIN.
Embedding یا Reference؛ مهمترین تصمیم طراحی
در MongoDB دو راه برای نگهداشتن دادهٔ مرتبط دارید:
- Embedding (جاسازی): دادهٔ وابسته را داخل همان سند میگذارید، مثل آیتمهای یک سفارش. خواندن سریع است و تغییر روی یک سند اتمیک انجام میشود.
- Reference (ارجاع): فقط
_idسند دیگر را نگه میدارید، مثلuser_idداخل سفارش. وقتی داده بین چند سند مشترک است یا بیحد رشد میکند، این روش مناسبتر است.
یک قاعدهٔ ساده: اگر دادهٔ فرزند همیشه همراه والد خوانده میشود و تعدادش محدود است، embed کنید. اگر مثل کامنتهای یک پست پرطرفدار ممکن است به هزاران مورد برسد، کالکشن جدا بسازید. حداکثر اندازهٔ هر سند BSON طبق صفحهٔ محدودیتهای MongoDB برابر 16 مبیبایت است و برای فایلهای بزرگتر باید سراغ GridFS یا فضای ذخیرهسازی آبجکت بروید.
MongoDB کجا خوب جواب میدهد؟
دانستن اینکه MongoDB چیست وقتی به کار میآید که بدانید کجا از آن استفاده کنید. اینها رایجترین موارد هستند:
- کاتالوگ محصول و CMS: هر آیتم ویژگیهای متفاوتی دارد و ساختار مدام تغییر میکند.
- بکاند اپلیکیشن موبایل و وب با Node.js: آبجکتهای جاوااسکریپت تقریباً همان شکلی در دیتابیس مینشینند که در کد دارید.
- لاگ رویداد و دادههای IoT: حجم نوشتن بالاست و هر رویداد فیلدهای خاص خودش را دارد. MongoDB برای این کار کالکشن مخصوص time series هم دارد.
- پروفایل کاربر و تنظیمات: هر کاربر مجموعهای از ترجیحات دارد که بهتر است یکجا خوانده شود.
- نمونهٔ اولیه و MVP: بدون نوشتن migration برای هر تغییر، مدل داده را همراه محصول عوض میکنید.
کجا MongoDB انتخاب خوبی نیست؟
اگر دادهٔ شما ذاتاً رابطهای است، مثل سیستم حسابداری با دهها جدول بههموابسته، گزارشگیریهای سنگین با JOIN های متعدد یا قیدهای سفت بین جدولها، یک دیتابیس رابطهای کار را سادهتر میکند. MongoDB تراکنش چندسندی دارد، ولی اگر بیشتر عملیاتتان به تراکنش روی چند کالکشن نیاز دارد، احتمالاً مدل داده را درست برای MongoDB طراحی نکردهاید یا ابزار مناسب را انتخاب نکردهاید.
انعطاف اسکیما هم دو لبه دارد. وقتی هیچ قانونی روی ساختار نباشد، بعد از چند ماه در یک کالکشن هم phone پیدا میکنید، هم phoneNumber و هم mobile. پایینتر میگوییم چطور با Schema Validation جلوی این را بگیرید.
MongoDB یا MySQL و PostgreSQL؟
| معیار | MongoDB | MySQL / PostgreSQL |
|---|---|---|
| مدل داده | سند BSON با آرایه و سند تو در تو | جدول با ستونهای از پیش تعریفشده |
| اسکیما | منعطف؛ اعتبارسنجی اختیاری با $jsonSchema |
ثابت؛ تغییر با ALTER و migration |
| زبان کوئری | MQL و Aggregation Pipeline | SQL |
| رابطه بین دادهها | embedding یا $lookup |
JOIN و کلید خارجی |
| تراکنش | روی یک سند همیشه اتمیک؛ چندسندی روی Replica Set | تراکنش کامل ACID روی هر تعداد جدول |
| مقیاس افقی | Sharding داخلی | معمولاً با ابزار یا معماری جانبی |
| مناسب برای | کاتالوگ، CMS، لاگ، بکاند اپ | مالی، ERP، گزارشگیری رابطهای |
مقایسهٔ دو دیتابیس رابطهای محبوب را در MySQL یا PostgreSQL نوشتهایم. خیلی از پروژهها هم ترکیبی کار میکنند: PostgreSQL برای سفارش و پرداخت، MongoDB برای کاتالوگ و لاگ، و Redis برای کش.
Replica Set و Sharding
بخش مهمی از جواب «MongoDB چیست» به معماری توزیعشدهٔ آن برمیگردد. دو سازوکار داخلی برای پایداری و رشد دارد:
Replica Set گروهی از نمونههای mongod است که یک دادهٔ یکسان را نگه میدارند. یک عضو Primary است و همهٔ نوشتنها را میگیرد؛ بقیه Secondary هستند و تغییرات را از روی لاگ عملیات (oplog) تکرار میکنند. اگر Primary از دسترس خارج شود، اعضای باقیمانده رأی میدهند و یک Secondary جای آن را میگیرد. توضیح کامل در مستند Replication آمده است.
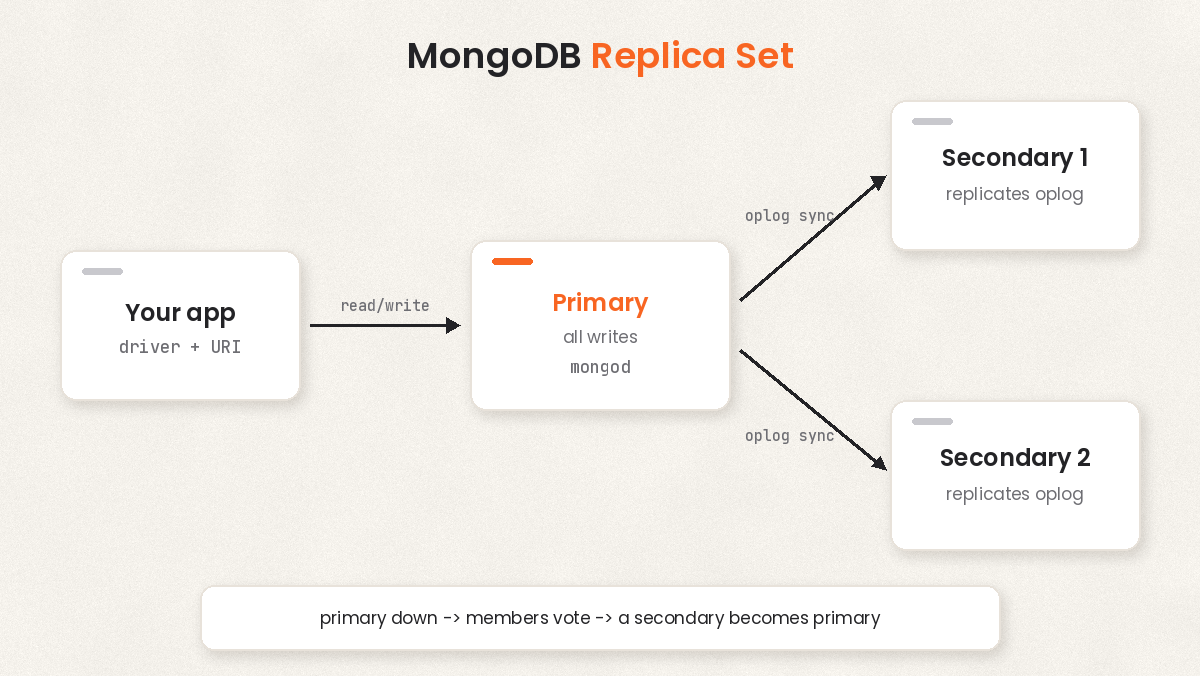
Sharding داده را بر اساس یک کلید (shard key) بین چند سرور پخش میکند تا هم حجم داده و هم بار نوشتن تقسیم شود. انتخاب shard key مهم است: کلیدی که همهٔ نوشتنها را به یک shard بفرستد، مثل تاریخ صعودی، سود sharding را از بین میبرد. بیشتر پروژهها سالها بدون sharding کار میکنند؛ تا وقتی ایندکسها و طراحی سند بهینه نشده، سراغش نروید.
تراکنش در MongoDB
هر عملیات روی یک سند در MongoDB اتمیک است. اگر در یک updateOne هم موجودی را کم کنید و هم وضعیت را عوض کنید، یا هر دو انجام میشود یا هیچکدام. برای همین طراحی درست سند (embed کردن دادهای که با هم تغییر میکند) نیاز به تراکنش را کم میکند.
وقتی واقعاً لازم است چند سند در چند کالکشن با هم تغییر کنند، MongoDB تراکنش چندسندی دارد. یک شرط مهم: طبق مستند تراکنشها، نمونهٔ مستقل (standalone) تراکنش را پشتیبانی نمیکند و دیتابیس باید بهشکل Replica Set اجرا شود. ابزارهایی مثل Prisma هم برای کار با MongoDB به Replica Set نیاز دارند. در دیتابیس ابری MongoDB چابکان میتوانید از تنظیمات سرویس Replica تکسرور را فعال کنید؛ مراحل در مستند فعالسازی Replica آمده است.
شروع کار با MongoDB در mongosh
ابزار خط فرمان رسمی MongoDB برای نسخههای جدید mongosh است و دستور قدیمی mongo از نسخهٔ ۶ کنار گذاشته شده است. با connection string وصل شوید و چند دستور پایه را امتحان کنید:
mongosh "mongodb://USER:PASSWORD@HOST:27017/?authSource=admin"

use shop

db.products.insertOne({
  name: "Mechanical Keyboard",
  tags: ["usb-c", "rgb"],
  specs: { switch: "brown", layout: "TKL" },
  stock: { warehouse: "THR", qty: 14 }
})

db.products.find({ tags: "rgb" })

db.products.updateOne(
  { name: "Mechanical Keyboard" },
  { $inc: { "stock.qty": -1 } }
)

db.products.createIndex({ tags: 1 })
db.products.find({ tags: "rgb" }).explain("executionStats")
چند نکته در همین مثال هست. کالکشن products را از قبل نساختیم؛ با اولین insertOne ساخته شد. برای فیلد تو در تو از نقطه استفاده کردیم ("stock.qty"). جستوجوی { tags: "rgb" } روی آرایه هم کار میکند و هر سندی را که rgb یکی از عضوهای آرایهاش باشد برمیگرداند. خروجی explain نشان میدهد کوئری از ایندکس استفاده کرده (IXSCAN) یا کل کالکشن را گشته (COLLSCAN).
اگر رابط گرافیکی را ترجیح میدهید، MongoDB Compass را نصب کنید. در دیتابیس ابری چابکان میتوانید Mongo Express را هم از بخش سرویسهای جانبی داشبورد فعال کنید؛ عمر این سرویسهای جانبی ۴۰ دقیقه است و بعد خودکار حذف میشوند.
اتصال برنامه به MongoDB با پایتون و Node.js
همهٔ درایورهای رسمی با connection string کار میکنند. آدرس را در کد ننویسید؛ آن را در متغیر محیطی مثل MONGODB_URI بگذارید. نمونه با درایور رسمی پایتون (PyMongo):
import os
from pymongo import MongoClient

client = MongoClient(os.environ["MONGODB_URI"])
db = client["shop"]

db.orders.insert_one({
    "user_id": 42,
    "items": [{"sku": "KB-01", "qty": 1}],
    "status": "paid",
})

for order in db.orders.find({"status": "paid"}).limit(5):
    print(order["_id"], order["items"])
و همین کار با درایور رسمی Node.js:
const { MongoClient } = require("mongodb");

const client = new MongoClient(process.env.MONGODB_URI);

async function main() {
  await client.connect();
  const orders = client.db("shop").collection("orders");
  const paid = await orders.countDocuments({ status: "paid" });
  console.log("paid orders:", paid);
  await client.close();
}

main().catch(console.error);
در برنامهٔ واقعی MongoClient را یک بار موقع بالا آمدن برنامه بسازید و در همهٔ درخواستها از همان استفاده کنید. درایور خودش connection pool را مدیریت میکند و ساختن کلاینت در هر درخواست، تعداد اتصالها را بیدلیل بالا میبرد. اگر از Mongoose در Node.js استفاده میکنید، همین قاعده برقرار است. شکل connection string دیتابیس چابکان و پارامتر authSource=admin را در مستند روشهای اتصال به MongoDB ببینید.
Aggregation Pipeline؛ گزارشگیری داخل MongoDB
برای گزارشهایی مثل «فروش هر محصول در ماه گذشته» لازم نیست همهٔ اسناد را به برنامه بیاورید و آنجا جمع بزنید. Aggregation Pipeline داده را از چند مرحلهٔ پشت سر هم عبور میدهد: فیلتر با $match، باز کردن آرایه با $unwind، گروهبندی با $group و مرتبسازی با $sort. مثال زیر پرفروشترین کالاها را از سفارشهای پرداختشده درمیآورد:
db.orders.aggregate([
  { $match: { status: "paid" } },
  { $unwind: "$items" },
  { $group: { _id: "$items.sku", sold: { $sum: "$items.qty" } } },
  { $sort: { sold: -1 } },
  { $limit: 10 }
])
مرحلهٔ $match را تا جای ممکن اول بگذارید تا MongoDB بتواند از ایندکس استفاده کند و اسناد کمتری به مراحل بعد برسند. اتصال دو کالکشن هم با مرحلهٔ $lookup انجام میشود، ولی اگر هر گزارش به چند $lookup نیاز دارد، طراحی سندها را دوباره نگاه کنید. فهرست کامل مراحل در مستند Aggregation آمده است.
ایندکس و Schema Validation
بدون ایندکس، MongoDB برای هر کوئری مجبور است همهٔ اسناد کالکشن را بخواند. این را مستند ایندکسها صریح گفته است. روی فیلدهایی که در فیلتر و مرتبسازی میآیند ایندکس بسازید و برای کوئریهایی مثل «سفارشهای پرداختشدهٔ یک کاربر به ترتیب تاریخ» ایندکس ترکیبی تعریف کنید. هر ایندکس هم سرعت نوشتن را کمی پایین میآورد و فضا میگیرد، پس ایندکس بیاستفاده را حذف کنید.
برای اینکه انعطاف اسکیما به بینظمی نرسد، روی کالکشنهای مهم قانون بگذارید:
db.createCollection("users", {
  validator: {
    $jsonSchema: {
      bsonType: "object",
      required: ["email", "createdAt"],
      properties: {
        email: { bsonType: "string", pattern: "^.+@.+$" },
        createdAt: { bsonType: "date" }
      }
    }
  }
})

db.users.createIndex({ email: 1 }, { unique: true })
از این به بعد سندی که email یا createdAt نداشته باشد، رد میشود و ایمیل تکراری هم ثبت نمیشود. بقیهٔ فیلدها همچنان آزادند. گزینههای بیشتر در مستند Schema Validation آمده است.
امنیت و بکاپ MongoDB
- پورت پیشفرض 27017 را روی اینترنت باز نگذارید. فقط سرورهای برنامه باید به آن دسترسی داشته باشند.
- احراز هویت را فعال کنید و برای هر برنامه کاربری با دسترسی فقط به دیتابیس خودش بسازید، نه کاربر admin.
- اگر ترافیک از شبکهٔ عمومی عبور میکند، TLS را روشن کنید.
- بکاپ را خارج از همان سرور نگه دارید و بازگردانی را دستکم یک بار امتحان کنید.
برای بکاپ منطقی، ابزارهای رسمی mongodump و mongorestore کافیاند:
mongodump --uri="mongodb://USER:PASSWORD@HOST:27017/?authSource=admin" --db=shop --gzip --out=./backup-2026-11

mongorestore --uri="mongodb://USER:PASSWORD@HOST:27017/?authSource=admin" --gzip ./backup-2026-11
در دیتابیس ابری چابکان بکاپ از داشبورد سرویس هم گرفته و بازگردانی میشود؛ روشها در مستند Backup و Restore در MongoDB آمده است.
راهاندازی MongoDB: روی سرور خودتان یا دیتابیس مدیریتشده؟
حالا که میدانید MongoDB چیست و کجا به کار میآید، باید تصمیم بگیرید نصب و نگهداریاش با چه کسی باشد:
| موضوع | نصب روی سرور ابری | دیتابیس مدیریتشده |
|---|---|---|
| نصب و ارتقای نسخه | با شما؛ از مخزن رسمی یا ایمیج داکر | نسخه را هنگام ساخت سرویس از پنل انتخاب میکنید |
| تنظیم امنیت | فایروال، کاربرها و TLS را خودتان تنظیم میکنید | نام کاربری و رمز از ابتدا فعال است و در داشبورد دیده میشود |
| بکاپ | اسکریپت mongodump و انتقال بکاپ با شماست | بکاپ خودکار و بازگردانی از داشبورد |
| ابزار مدیریت | Compass یا نصب Mongo Express روی سرور | Mongo Express و Adminer با یک کلیک |
| مناسب برای | تیمی که کنترل کامل روی mongod.conf و چند نود میخواهد |
تیمی که میخواهد روی کد محصول تمرکز کند |
اگر کنترل کامل میخواهید، MongoDB را روی سرور ابری چابکان نصب کنید و قبل از هر چیز دسترسی پورت را محدود کنید. اگر نمیخواهید درگیر نصب و بکاپ شوید، دیتابیس ابری MongoDB چابکان در دیتاسنتر ایران یا اروپا با چند کلیک ساخته میشود و مشخصات اتصال را در داشبورد سرویس میبینید. برنامهتان را هم میتوانید روی هاست Node.js یا هاست پایتون چابکان اجرا کنید و connection string را در متغیر محیطی آن بگذارید. برای مقایسهٔ پلنها به جدول تعرفهٔ صفحهٔ محصول سر بزنید؛ فهرست بقیهٔ موتورها هم در صفحهٔ دیتابیس ابری هست.
تفاوت این دو مسیر را با جزئیات بیشتر در دیتابیس مدیریتشده چیست و DBaaS چیست نوشتهایم. برای محیط توسعهٔ محلی هم مقالهٔ Docker Compose چیست نشان میدهد چطور MongoDB را کنار برنامه بالا بیاورید.
اشتباههای رایج در کار با MongoDB
- کپیکردن طراحی جدولهای SQL: اگر برای هر موجودیت یک کالکشن بسازید و مدام
$lookupبزنید، هزینهٔ MongoDB را میدهید و سودش را نمیبرید. - آرایههای بیانتها: آرایهای که مدام بزرگ میشود، مثل همهٔ بازدیدهای یک صفحه، سند را به سقف 16 مبیبایت نزدیک میکند و بهروزرسانی را کند میکند.
- کوئری بدون ایندکس: روی چند هزار سند متوجه نمیشوید؛ روی چند میلیون سند هر درخواست ثانیهها طول میکشد. خروجی
explainرا چک کنید. - اتصال با کاربر admin: اگر برنامه نشت کند، مهاجم به همهٔ دیتابیسها دسترسی پیدا میکند.
- انتظار تراکنش روی نمونهٔ مستقل: کد تراکنش روی standalone خطا میدهد. اول Replica را فعال کنید.
سؤالات متداول
MongoDB چیست و به زبان ساده چه کاری میکند؟
MongoDB یک دیتابیس NoSQL سندمحور است که هر رکورد را بهشکل یک سند JSONمانند ذخیره میکند. هر سند میتواند فیلدها، آرایهها و اسناد تو در توی خودش را داشته باشد و لازم نیست همهٔ اسناد یک کالکشن ساختار یکسان داشته باشند.
MongoDB رایگان است؟
نسخهٔ Community را میتوانید رایگان روی سرور خودتان اجرا کنید. نسخههایی که بعد از ۱۶ اکتبر ۲۰۱۸ منتشر شدهاند تحت مجوز SSPL هستند و درایورهای رسمی مجوز Apache 2.0 دارند. جزئیات در صفحهٔ مجوز MongoDB آمده است.
MongoDB جایگزین MySQL است؟
برای همهٔ پروژهها نه. برای دادهای با ساختار متغیر مثل کاتالوگ و لاگ، MongoDB کار را سادهتر میکند. برای دادههای رابطهای با JOIN زیاد و تراکنشهای مالی، MySQL یا PostgreSQL انتخاب طبیعیتری است. خیلی از تیمها هر دو را کنار هم استفاده میکنند.
MongoDB تراکنش دارد؟
بله. عملیات روی یک سند همیشه اتمیک است و تراکنش چندسندی هم وجود دارد، به شرطی که دیتابیس بهشکل Replica Set یا کلاستر shard شده اجرا شود. نمونهٔ مستقل از تراکنش پشتیبانی نمیکند.
با وردپرس میشود از MongoDB استفاده کرد؟
نه. وردپرس برای MySQL یا MariaDB نوشته شده است. MongoDB بیشتر در پروژههایی کاربرد دارد که با Node.js، پایتون، Go یا فریمورکهایی مثل NestJS و FastAPI ساخته میشوند.
برای شروع یادگیری MongoDB چه چیزی لازم است؟
آشنایی با JSON و یک زبان برنامهنویسی کافی است. یک دیتابیس آزمایشی بسازید، با mongosh چند سند اضافه و جستوجو کنید، بعد با درایور زبان خودتان یک API کوچک بنویسید. وقتی اولین کوئری کند را دیدید، سراغ ایندکس و Aggregation Pipeline بروید.