

فرض کنید پشتیبانی سایت شما چند صد سؤال و جواب ذخیرهشده دارد. کاربری مینویسد «پول از حسابم کم شد ولی سرویس فعال نشد». جوابِ درست در پایگاه دانش هست، اما با عنوان «پرداخت موفق بود اما سفارش ثبت نشد». جستوجوی LIKE در MySQL هیچکدام از این کلمهها را مشترک نمیبیند و نتیجهای برنمیگرداند. انسان در یک نگاه میفهمد این دو جمله یک مشکل را میگویند؛ دیتابیس معمولی نمیفهمد.
دیتابیس برداری برای همین مسئله ساخته شده است: بهجای کلمهها، «معنا» را مقایسه میکند. در این راهنما میگوییم دیتابیس برداری چیست، Embedding از کجا میآید، جستوجوی شباهت چطور کار میکند و چرا تقریباً هر چتبات RAG یکی از آنها را پشت خودش دارد. بعد با Qdrant، که یکی از پرکاربردترین دیتابیسهای برداری متنباز است، یک نمونهٔ واقعی با پایتون میسازیم.
دیتابیس برداری چیست؟
دیتابیس برداری (Vector Database) دیتابیسی است که برای هر رکورد یک بردار عددی نگه میدارد، یعنی آرایهای از چند صد یا چند هزار عدد اعشاری، و میتواند در میان میلیونها بردار، نزدیکترینها را به یک بردار ورودی در چند میلیثانیه پیدا کند. کنار هر بردار معمولاً دادهٔ معمولی هم ذخیره میشود: متن اصلی، شناسهٔ محصول، زبان، تاریخ یا هر فیلدی که بعداً بخواهید روی آن فیلتر کنید.
کار اصلی دیتابیس برداری جوابدادن به این سؤال است: «کدام رکوردها از نظر معنا به این ورودی شبیهترند؟» در MySQL سؤال این است که کدام ردیف دقیقاً شرط WHERE را دارد. در دیتابیس برداری نتیجه با یک امتیاز شباهت مرتب میشود و حتی وقتی هیچ کلمهٔ مشترکی وجود ندارد، نزدیکترین گزینهها برگردانده میشوند.
Embedding چیست و بردارها از کجا میآیند؟
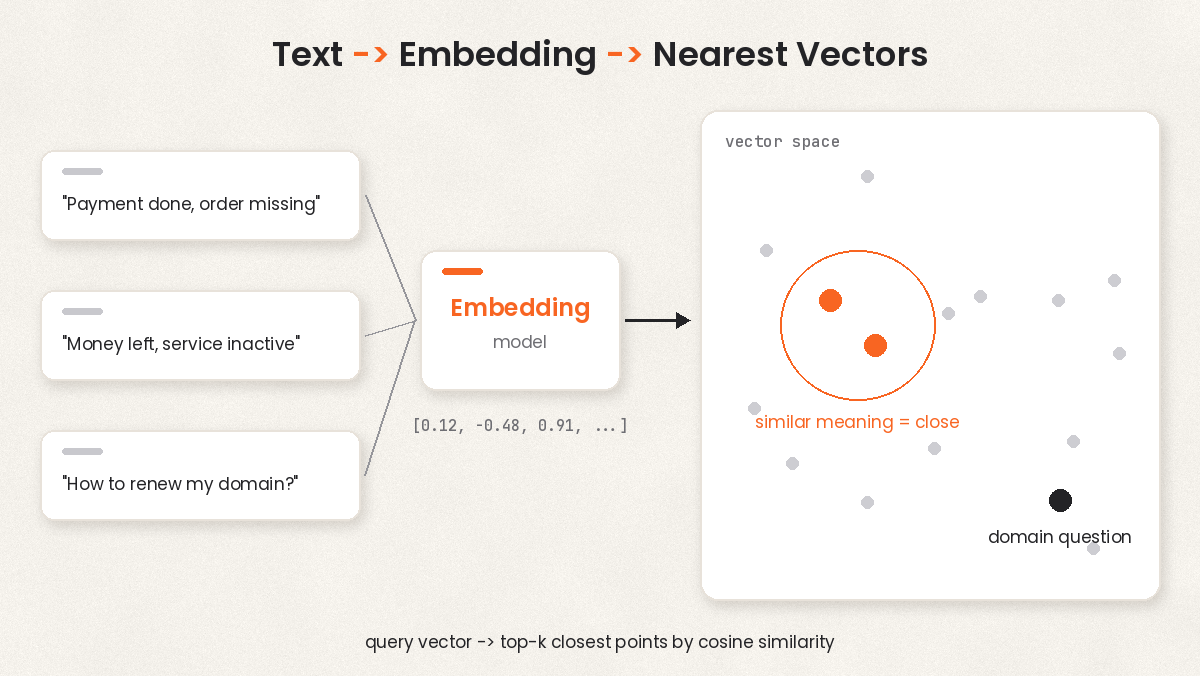
برای اینکه بفهمید دیتابیس برداری چیست، اول باید Embedding را بشناسید. خود دیتابیس برداری متن یا تصویر را نمیفهمد. این کار مدل Embedding است: یک مدل یادگیری ماشین که متن، تصویر یا صوت را میگیرد و یک بردار با طول ثابت برمیگرداند. مدل طوری آموزش دیده که ورودیهای هممعنا بردارهای نزدیک به هم بگیرند. «پول کم شد ولی سرویس فعال نشد» و «پرداخت موفق بود اما سفارش ثبت نشد» در فضای برداری کنار هم میافتند، در حالی که «چطور دامنه را تمدید کنم» از هر دو دور است.
چند نکتهٔ عملی دربارهٔ Embedding که از روز اول به کارتان میآید:
- طول بردار به مدل بستگی دارد. هر مدل خروجی با تعداد بعد ثابتی دارد، مثلاً ۳۸۴ یا ۱۵۳۶. همهٔ بردارهای یک collection باید یک طول داشته باشند، پس مدل را عوض کنید، باید همهٔ داده را دوباره بردار کنید.
- برای متن فارسی مدل چندزبانه بگیرید. بعضی مدلها فقط با متن انگلیسی آموزش دیدهاند و روی فارسی نتیجهٔ ضعیفی میدهند.
- ورودی و سؤال باید با یک مدل بردار شوند. برداری که با مدل A ساخته شده با بردار مدل B قابل مقایسه نیست.
جستوجوی شباهت چطور کار میکند؟
وقتی کاربر سؤالی میپرسد، همان مدل Embedding سؤال را به بردار تبدیل میکند. دیتابیس برداری فاصلهٔ این بردار را با بردارهای ذخیرهشده میسنجد و چند مورد نزدیکتر را برمیگرداند. به این کار k-NN یا جستوجوی نزدیکترین همسایهها میگویند. «نزدیک» با یک معیار فاصله تعریف میشود. Qdrant طبق مستند Collections این چهار معیار را پشتیبانی میکند:
| معیار | نام در Qdrant | چه چیزی را میسنجد | کی سراغش بروید |
|---|---|---|---|
| شباهت کسینوسی | Cosine |
زاویهٔ بین دو بردار، بدون توجه به طول آنها | پیشفرض رایج برای Embedding متن |
| ضرب داخلی | Dot |
هم جهت و هم طول بردار | وقتی مستند مدل Embedding آن را توصیه کرده |
| فاصلهٔ اقلیدسی | Euclid |
فاصلهٔ خط مستقیم بین دو نقطه | بعضی مدلهای تصویر و دادهٔ عددی |
| فاصلهٔ منهتن | Manhattan |
جمع اختلاف مؤلفهها | کاربردهای خاص؛ برای متن کمتر رایج است |
قاعدهٔ ساده این است: معیاری را انتخاب کنید که مدل Embedding شما با آن آموزش دیده و در مستندش نوشته شده. Qdrant کسینوسی را روی بردارهای نرمالشده با ضرب داخلی حساب میکند و بردارها را هنگام آپلود خودش نرمال میکند.
مقایسهٔ سؤال با تکتک میلیونها بردار کند است. برای همین دیتابیسهای برداری از جستوجوی تقریبی (ANN) استفاده میکنند. Qdrant برای بردارهای چگال فقط از HNSW استفاده میکند؛ یک گراف چندلایه که لایههای بالایش پراکندهاند و پرشهای بلند دارند و لایههای پایینی متراکمترند. جستوجو از بالا شروع میشود و لایهبهلایه به همسایههای نزدیکتر میرسد. نتیجه تقریبی است، اما در عمل بسیار نزدیک به جستوجوی کامل و چند مرتبه سریعتر است. جزئیات در مستند Indexing آمده است.
جستوجوی متنی معمولی یا دیتابیس برداری؟
دیتابیس برداری جای دیتابیس اصلی را نمیگیرد. کاربر، سفارش و صورتحساب همچنان در MySQL یا PostgreSQL میمانند. این جدول نشان میدهد هر روش کجا جواب میدهد:
| موضوع | جستوجوی کلمهای (LIKE / Full-text) | جستوجوی برداری |
|---|---|---|
| مبنای تطبیق | کلمههای مشترک | نزدیکی معنایی |
| هممعنی و بازنویسی جمله | معمولاً پیدا نمیکند | پیدا میکند |
| کد محصول، شماره سفارش، نام دقیق | دقیق و قابلاعتماد | ممکن است نتیجهٔ نزدیک ولی غلط بدهد |
| جستوجو بین زبانها | نه | با مدل چندزبانه بله |
| هزینهٔ آمادهسازی | یک ایندکس متنی | اجرای مدل Embedding روی همهٔ داده |
| خروجی | مطابق یا نامطابق | فهرست مرتبشده با امتیاز شباهت |
به همین دلیل خیلی از سیستمها هر دو را ترکیب میکنند. پایینتر در بخش جستوجوی ترکیبی به آن برمیگردیم.
Qdrant چیست؟
حالا که میدانید دیتابیس برداری چیست، سراغ یکی از نمونههای واقعی آن برویم. Qdrant (کیودرانت) یک دیتابیس برداری متنباز با مجوز Apache 2.0 است که با زبان Rust نوشته شده. روی یک کانتینر داکر بالا میآید و دو رابط دارد: REST API روی پورت 6333 و gRPC روی پورت 6334. یک داشبورد وب هم روی آدرس /dashboard دارد که برای دیدن collectionها و اجرای کوئری آزمایشی مفید است. کلاینت رسمی برای پایتون، TypeScript، Rust، Go، Java و C# منتشر شده و LangChain و LlamaIndex هم آن را پشتیبانی میکنند.
مفاهیم Qdrant کم و سرراستاند:
| مفهوم | معادل تقریبی در SQL | توضیح |
|---|---|---|
| Collection | جدول | مجموعهای از pointها با طول بردار و معیار فاصلهٔ یکسان |
| Point | ردیف | یک شناسه (عدد یا UUID)، یک یا چند بردار و یک payload |
| Payload | ستونهای معمولی | دادهٔ JSON کنار بردار؛ مثل متن، دسته، زبان یا تاریخ |
| Named vectors | چند ستون برداری | چند بردار با طول و معیار متفاوت در یک point، مثلاً یکی برای عنوان و یکی برای تصویر |
| Payload index | ایندکس روی ستون | فیلتر روی payload را سریع میکند |
فیلتر یکی از نقاط قوت Qdrant است. میتوانید بگویید «شبیهترین جوابها را بده، اما فقط از دستهٔ billing و فقط به زبان فارسی». مستند رسمی تأکید میکند که ایندکس برداری فقط جستوجوی برداری را سریع میکند و برای فیلتر سریع باید روی همان فیلدهای payload ایندکس بسازید. Qdrant خودش تصمیم نمیگیرد کدام فیلد ایندکس شود؛ این انتخاب با شماست.
کوانتیزاسیون: کمکردن حافظهٔ بردارها
بردارها حافظه میخورند. هر مؤلفه معمولاً یک عدد اعشاری ۳۲ بیتی است، پس یک میلیون بردار ۱۵۳۶ بعدی بدون ایندکس حدود ۶ گیگابایت جا میگیرد. Qdrant برای کمکردن این حجم چند روش کوانتیزاسیون دارد. طبق راهنمای Quantization:
- Scalar: هر مؤلفه را از float ۳۲ بیتی به عدد صحیح ۸ بیتی میبرد؛ حدود ۴ برابر فشردهسازی با افت دقت کم.
- Binary: هر مؤلفه را به یک یا دو بیت میرساند و تا ۳۲ برابر فشرده میکند؛ برای بردارهای با بعد بالا مناسبتر است.
- Product: بردار را تکهتکه فشرده میکند و تا ۶۴ برابر جا آزاد میکند، اما کندتر است و دقت بیشتری از دست میدهد.
تا وقتی دادهتان چند ده هزار بردار است، لازم نیست درگیر این تنظیم شوید. وقتی حافظه محدودیت اصلی شد، اول Scalar را امتحان کنید و دقت نتایج را با چند سؤال واقعی بسنجید.
راهاندازی Qdrant با Docker
برای تست روی سیستم خودتان، دستور رسمی Quickstart کافی است:
docker pull qdrant/qdrant

docker run -p 6333:6333 -p 6334:6334 \
    -v "$(pwd)/qdrant_storage:/qdrant/storage:z" \
    qdrant/qdrant
بعد از اجرا، REST API روی localhost:6333 و داشبورد روی localhost:6333/dashboard در دسترس است. داده در پوشهٔ qdrant_storage میماند و با پاکشدن کانتینر از بین نمیرود. یک نکتهٔ مهم از مستند Quickstart: در تنظیمات پیشفرض نه رمزنگاری فعال است و نه احراز هویت. هر کسی که به پورت دسترسی شبکهای داشته باشد، به داده دسترسی دارد. پس این دستور را مستقیم روی سرور عمومی اجرا نکنید.
اگر با docker run آشنا نیستید یا میخواهید Qdrant را کنار برنامه و دیتابیس دیگر بالا بیاورید، مقالهٔ Docker Compose چیست قدمبهقدم توضیح داده است.
مثال عملی: جستوجوی معنایی روی سؤالات پشتیبانی با پایتون
در این مثال چند سؤال پشتیبانی را با یک مدل Embedding چندزبانه بردار میکنیم، در Qdrant ذخیره میکنیم و بعد با یک جملهٔ متفاوت جستوجو میکنیم. اول کتابخانهها را نصب کنید:
pip install qdrant-client sentence-transformersحالا collection را بسازید و داده را وارد کنید. طول بردار را از خود مدل میخوانیم تا با عوضکردن مدل، کد نشکند:
from qdrant_client import QdrantClient, models
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2")
client = QdrantClient(url="http://localhost:6333")

docs = [
    {"id": 1, "category": "billing", "text": "Payment was successful but the order was not created."},
    {"id": 2, "category": "billing", "text": "How do I get an invoice for my last payment?"},
    {"id": 3, "category": "domain", "text": "How can I renew my domain before it expires?"},
    {"id": 4, "category": "hosting", "text": "My website shows a 502 error after deploy."},
]

client.create_collection(
    collection_name="support_faq",
    vectors_config=models.VectorParams(
        size=model.get_sentence_embedding_dimension(),
        distance=models.Distance.COSINE,
    ),
)

client.create_payload_index(
    collection_name="support_faq",
    field_name="category",
    field_schema="keyword",
)

vectors = model.encode([d["text"] for d in docs])
client.upsert(
    collection_name="support_faq",
    points=[
        models.PointStruct(
            id=d["id"],
            vector=v.tolist(),
            payload={"category": d["category"], "text": d["text"]},
        )
        for d, v in zip(docs, vectors)
    ],
)
و جستوجو. متن نمونهها را انگلیسی گذاشتهایم تا کد خوانا بماند؛ مدل چندزبانه است و با متن فارسی هم همینطور کار میکند. دقت کنید که سؤال کاربر با پاسخ درست تقریباً هیچ کلمهٔ مهم مشترکی ندارد:
question = "Money left my account but the service is still inactive"

hits = client.query_points(
    collection_name="support_faq",
    query=model.encode(question).tolist(),
    query_filter=models.Filter(
        must=[models.FieldCondition(key="category", match=models.MatchValue(value="billing"))]
    ),
    limit=3,
    with_payload=True,
).points

for hit in hits:
    print(round(hit.score, 3), hit.payload["text"])
خروجی باید پاسخ مربوط به پرداخت را با بالاترین امتیاز نشان دهد. چون فیلتر روی category گذاشتهایم و برای همین فیلد payload index ساختهایم، با بزرگشدن داده هم فیلتر سریع میماند. در محیط واقعی متن کامل را در payload نگه دارید یا شناسهٔ رکورد را ذخیره کنید تا متن را از دیتابیس اصلی بخوانید.
نقش دیتابیس برداری در RAG
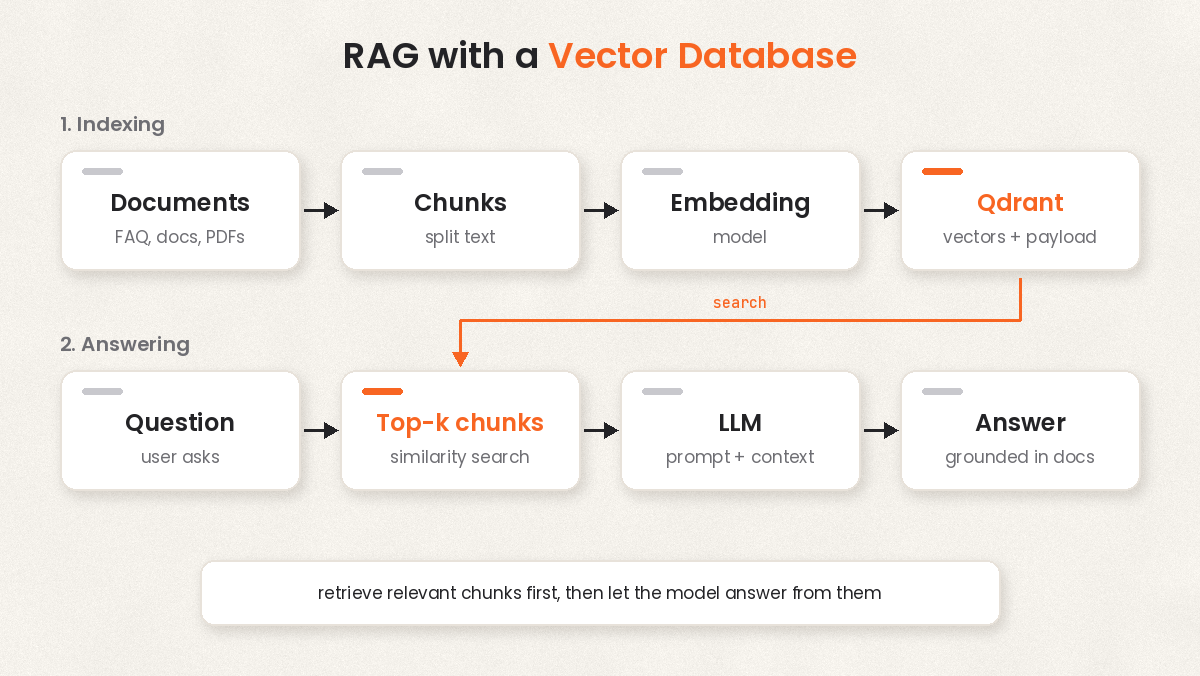
RAG (Retrieval-Augmented Generation) یعنی قبل از اینکه سؤال را به مدل زبانی بدهید، چند تکهٔ مرتبط از اسناد خودتان را پیدا کنید و همراه سؤال بفرستید. مدل جواب را بر اساس همان متنها مینویسد و کمتر از خودش چیزی میسازد. اگر بپرسید دیتابیس برداری چیست و چه سهمی در RAG دارد، جوابش بخش Retrieval این زنجیره است.
مراحل یک سیستم RAG ساده:
- تکهکردن اسناد: مستندات، FAQ یا قراردادها را به تکههای چند پاراگرافی تقسیم کنید. تکهٔ خیلی بلند معنا را رقیق میکند و تکهٔ خیلی کوتاه زمینه را از دست میدهد.
- بردارکردن و ذخیره: هر تکه را با مدل Embedding بردار کنید و با متن و منبعش در Qdrant بگذارید.
- بازیابی: سؤال کاربر را بردار کنید و چند تکهٔ نزدیک را بگیرید.
- تولید جواب: تکهها را در prompt بگذارید و از مدل زبانی بخواهید فقط بر اساس آنها جواب بدهد.
ادامهٔ همان مثال پایتون، این بار با یک API سازگار با OpenAI برای مرحلهٔ آخر:
import os
from openai import OpenAI

llm = OpenAI(base_url=os.environ["LLM_BASE_URL"], api_key=os.environ["LLM_API_KEY"])

def answer(question: str) -> str:
    hits = client.query_points(
        collection_name="support_faq",
        query=model.encode(question).tolist(),
        limit=4,
        with_payload=True,
    ).points
    context = "\n\n".join(h.payload["text"] for h in hits)

    response = llm.chat.completions.create(
        model=os.environ["LLM_MODEL"],
        messages=[
            {"role": "system", "content": "Answer only from the context. If it is not there, say you do not know."},
            {"role": "user", "content": f"Context:\n{context}\n\nQuestion: {question}"},
        ],
    )
    return response.choices[0].message.content
اگر نمیخواهید کد بنویسید، همین زنجیره را در n8n هم میتوانید بسازید؛ n8n نودهای آماده برای Qdrant و مدلهای زبانی دارد. برای انتخاب مدل مناسب هم مقالهٔ هوش مصنوعی ابری چیست را بخوانید.
جستوجوی ترکیبی؛ وقتی معنا کافی نیست
جستوجوی برداری در پیدا کردن معنا خوب است، اما در پیدا کردن عبارت دقیق ضعیف است. اگر کاربر کد خطای ERR_SSL_PROTOCOL_ERROR یا نام دقیق یک پلن را بنویسد، ممکن است نتیجهای «شبیه» بگیرد که درست نیست. راهحل، جستوجوی ترکیبی (Hybrid Search) است.
Qdrant از نسخهٔ 1.10 کوئری ترکیبی دارد و طبق مستند فعلی میتواند یک داده را همزمان با بردار چگال (معنایی)، بردار تُنُک (sparse، مثل SPLADE) و جستوجوی BM25 روی متن payload جستوجو کند و نتیجهها را با روشهایی مثل RRF (Reciprocal Rank Fusion) در یک فهرست ادغام کند. RRF به مواردی امتیاز بیشتری میدهد که در چند روش جستوجو در رتبههای بالا آمدهاند. توضیح کامل در مستند Hybrid Queries آمده است.
مقایسهٔ Qdrant با pgvector، Milvus، Chroma و Pinecone
جواب سؤال «دیتابیس برداری چیست» فقط Qdrant نیست. انتخاب بیشتر به حجم داده و زیرساخت فعلی شما بستگی دارد:
| گزینه | نوع | نقطهٔ قوت | مناسب برای |
|---|---|---|---|
| Qdrant | دیتابیس برداری مستقل، متنباز | فیلتر قوی روی payload، جستوجوی ترکیبی، کوانتیزاسیون | RAG و جستوجوی معنایی با فیلترهای زیاد |
| pgvector | افزونهٔ PostgreSQL | بردار کنار جدولهای معمولی، با JOIN و تراکنش | تیمی که PostgreSQL دارد و دادهٔ برداری متوسطی دارد |
| Milvus | دیتابیس برداری توزیعشده، متنباز | طراحی برای مقیاس خیلی بزرگ و چند نود | پروژههای بزرگ با تیم زیرساخت |
| Chroma | دیتابیس برداری سبک، متنباز | شروع سریع داخل کد پایتون | نمونهٔ اولیه و پروژههای کوچک |
| Pinecone | سرویس مدیریتشدهٔ تجاری | بدون نصب و نگهداری | تیمهایی که زیرساخت خارجی برایشان مشکلی ندارد |
اگر پروژهتان همین حالا روی PostgreSQL است و چند ده هزار سند دارید، pgvector شروع سادهتری است؛ هم HNSW دارد و هم IVFFlat. وقتی داده بزرگتر شد یا به فیلترهای پیچیده و جستوجوی ترکیبی نیاز پیدا کردید، دیتابیس برداری مستقل مثل Qdrant کار را راحتتر میکند. برای مقایسهٔ خود PostgreSQL با MySQL هم مقالهٔ MySQL یا PostgreSQL را ببینید.
امنیت Qdrant در محیط واقعی
Qdrant بهصورت پیشفرض بدون احراز هویت بالا میآید. پیش از اینکه آن را روی اینترنت در دسترس بگذارید، طبق مستند Security این کارها را انجام دهید:
- کلید API: با متغیر محیطی
QDRANT__SERVICE__API_KEYکلید تعریف کنید. کلاینتها کلید را در هدرapi-keyمیفرستند. - کلید فقطخواندنی: برای بخشی از برنامه که فقط جستوجو میکند، از
QDRANT__SERVICE__READ_ONLY_API_KEYاستفاده کنید تا با نشت آن کسی نتواند داده را پاک کند. - HTTPS: کلید API روی HTTP ساده قابل شنود است؛ ارتباط را رمزنگاری کنید.
- پورتها: اگر از gRPC استفاده نمیکنید، پورت
6334را باز نگذارید.
اتصال با کلید در پایتون این شکلی است:
import os
from qdrant_client import QdrantClient

client = QdrantClient(
    url="https://qdrant.example.com",
    api_key=os.environ["QDRANT_API_KEY"],
)
print(client.get_collections())چکلیست پیش از بردن دیتابیس برداری به محیط واقعی
- مدل Embedding را قبل از واردکردن دادهٔ زیاد نهایی کنید؛ تعویض مدل یعنی بردارکردن دوبارهٔ همهچیز.
- متن یا شناسهٔ منبع را در payload نگه دارید. برداری که نمیدانید از کدام سند آمده، به کاربر قابل نمایش نیست.
- روی هر فیلدی که فیلتر میکنید payload index بسازید.
- چند ده سؤال واقعی کاربران را جمع کنید و بعد از هر تغییر در مدل یا اندازهٔ تکهها، نتیجه را با آنها بسنجید.
- از collection بکاپ بگیرید. ساختن دوبارهٔ Embedding برای میلیونها سند هم زمان میبرد و هم هزینهٔ API دارد.
راهاندازی Qdrant روی چابکان
وقتی روشن شد دیتابیس برداری چیست و کجای پروژهتان به کار میآید، نوبت راهاندازی است. اگر نمیخواهید Qdrant را روی سرور شخصی نصب و نگهداری کنید، سرویس Qdrant چابکان از بخش برنامههای آماده با چند کلیک ساخته میشود. موقعیت سرویس را بین دیتاسنتر ایران و اروپا انتخاب میکنید، دامنهٔ اختصاصی و HTTPS را از بخش دامنهها وصل میکنید (راهنمای دامنه و HTTPS) و از زبانهٔ بکاپها نسخهٔ دستی میگیرید (راهنمای بکاپ). پرداخت ساعتی و به تومان است؛ برای مقایسهٔ پلنها به جدول تعرفهٔ صفحهٔ سرویس سر بزنید.
برای مرحلهٔ تولید جواب در RAG، هوش مصنوعی ابری چابکان یک API سازگار با OpenAI و پرداخت ریالی دارد و کد بالا با تغییر LLM_BASE_URL و کلید به آن وصل میشود. با ۱۰۰ هزار تومان اعتبار هدیه میتوانید مدلها را امتحان کنید. اسکریپت پایتون یا API خودتان را هم روی هاست پایتون اجرا کنید و اگر بردارها را کنار دادههای اصلی میخواهید، دیتابیس ابری PostgreSQL گزینهٔ دیگر است.
سؤالات متداول
دیتابیس برداری چیست به زبان ساده؟
دیتابیسی که بهجای مقایسهٔ کلمهها، معنای داده را مقایسه میکند. هر متن یا تصویر با یک مدل Embedding به آرایهای از اعداد تبدیل میشود و دیتابیس برداری نزدیکترین آرایهها به سؤال شما را پیدا میکند.
آیا دیتابیس برداری جایگزین MySQL یا PostgreSQL میشود؟
نه. دیتابیس برداری برای جستوجوی شباهت ساخته شده و تراکنشهای مالی، JOIN و گزارشگیری همچنان کار دیتابیس رابطهای است. بیشتر پروژهها هر دو را کنار هم دارند و شناسهٔ رکورد را در payload نگه میدارند.
Qdrant رایگان است؟
Qdrant متنباز است و با مجوز Apache 2.0 منتشر میشود، پس میتوانید آن را روی سرور خودتان اجرا کنید. هزینه فقط مربوط به سرور یا سرویسی است که Qdrant روی آن اجرا میشود.
برای ساخت Embedding حتماً به API خارجی نیاز دارم؟
نه. مدلهای متنباز مثل مدلهای sentence-transformers را میتوانید روی سرور خودتان اجرا کنید؛ مثال پایتون همین مقاله همین کار را میکند. API هم گزینهٔ دیگری است که نگهداری مدل را از دوش شما برمیدارد.
Qdrant از متن فارسی پشتیبانی میکند؟
Qdrant فقط بردار و payload را ذخیره میکند و زبان برایش مهم نیست. کیفیت نتیجه روی متن فارسی به مدل Embedding بستگی دارد، پس مدلی انتخاب کنید که فارسی را در دادههای آموزشیاش داشته باشد.
چند سند لازم است تا دیتابیس برداری ارزشش را داشته باشد؟
عدد ثابتی ندارد. اگر چند صد سند دارید، جستوجوی برداری از همان روز اول نتیجهها را بهتر میکند، حتی اگر سرعت مسئله نباشد. وقتی به صدها هزار یا میلیونها بردار رسیدید، ایندکس HNSW، فیلتر و کوانتیزاسیون است که فرق اصلی را میسازد.


