
میخواهی به اپت یک خلاصهساز متن یا یک دستیار پشتیبانی اضافه کنی. سراغ پنل OpenAI میروی و میبینی ایران در فهرست کشورهای پشتیبانیشده نیست و کارت بانکیات هم جایی قبول نمیشود. همکارت Claude را ترجیح میدهد و نفر سوم تیم با Gemini کار میکند؛ هر کدام SDK، کلید و صورتحساب خودش را دارد. با هوش مصنوعی ابری مدلها روی زیرساخت سرویسدهنده اجرا میشوند و تو با یک درخواست HTTP متن میفرستی و جواب میگیری.
پایینتر سه مقدار base_url، api_key و model را باز میکنیم، یک درخواست واقعی با curl میفرستیم، و سه مسیر رایج را از نظر هزینه و دردسر کنار هم میگذاریم: مدل روی سرور اختصاصی هوش مصنوعی خودت، API مستقیم هر شرکت، و یک API متمرکز.
هوش مصنوعی ابری چیست؟
هوش مصنوعی ابری یعنی استفاده از مدلهای هوش مصنوعی، که بیشترشان مدل زبانی بزرگ هستند، از راه اینترنت و بدون اینکه مدل یا GPU را خودت نگه داری. مدل روی سرورهای سرویسدهنده بارگذاری شده است؛ تو درخواستی با متن ورودی میفرستی و خروجی را به شکل JSON تحویل میگیری. اگر هنوز با خود مفهوم مدل زبانی راحت نیستی، اول مدل زبانی بزرگ (LLM) چیست؟ را بخوان.
در عمل هوش مصنوعی ابری دو شکل رایج دارد:
- API مستقیم سازنده مدل: هر شرکت (OpenAI، Anthropic، Google) آدرس، کلید و پنل پرداخت خودش را دارد.
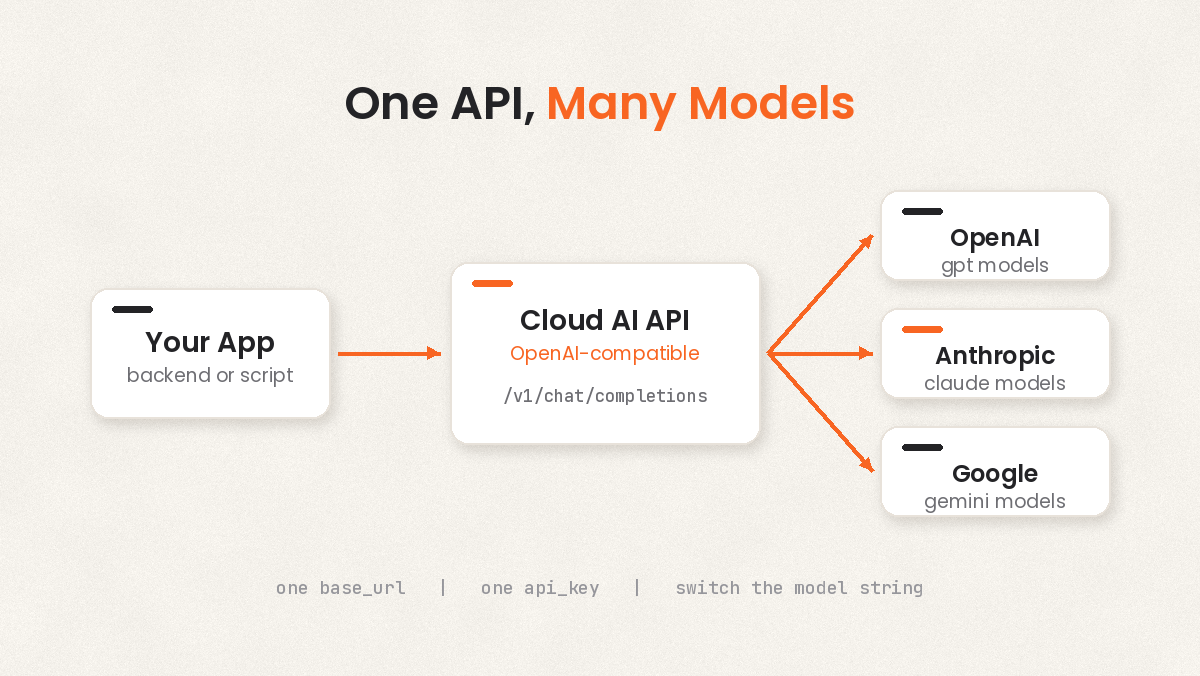
- درگاه متمرکز یا AI Gateway: سرویسی واسط که چند مدل از چند سازنده را پشت یک آدرس و یک کلید جمع میکند و مصرف همه را یکجا گزارش میدهد.
برای برنامهات مهم نیست پشت این آدرس کدام مدل نشسته است. تا وقتی قالب درخواست و پاسخ ثابت بماند، کدت عوض نمیشود. به این قالب ثابت OpenAI-compatible میگویند.
API هوش مصنوعی ابری چطور کار میکند؟
هر درخواست به API هوش مصنوعی یک درخواست HTTP معمولی از نوع POST است. بدنه درخواست شامل شناسه مدل و آرایهای از پیامهاست و پاسخ شامل متن تولیدشده و تعداد توکنهای مصرفی. برای وصل شدن به هر سرویس سازگار با OpenAI فقط سه مقدار لازم داری.
سه مقدار اصلی: base_url، API key و model
| مقدار | کارش چیست | نمونه |
|---|---|---|
base_url | آدرس پایهای که SDK مسیرهایی مثل /chat/completions را به انتهای آن اضافه میکند | https://api.openai.com/v1 |
api_key | کلید محرمانهای که در هدر Authorization: Bearer فرستاده میشود و مصرف را به حساب تو ثبت میکند | sk-... |
model | شناسه فنی مدل؛ با اسم نمایشی آن در سایت یکی نیست | openai/gpt-4o-mini |
بیشتر خطاهای روز اول از همین سه مقدار میآیند: /v1 که دو بار در آدرس تکرار شده، کلیدی که در ترمینال دیگری export شده، یا اسم مدلی که از روی بنر سایت کپی شده است.
OpenAI-compatible یعنی چه؟
API چت OpenAI زودتر از بقیه فراگیر شد و قالب درخواست آن، همراه با SDKهای Python و Node.js، به مرور حکم استاندارد پیدا کرد. حالا درگاههای ابری و ابزارهای self-hosted مثل vLLM و Ollama همان مسیرها و همان قالب JSON را پیاده میکنند. یعنی با کتابخانه رسمی openai و فقط با عوض کردن base_url به سرویس دیگری وصل میشوی.
مسیرهای پرکاربرد اینها هستند:
GET /v1/modelsبرای دیدن فهرست مدلهایی که کلیدت به آنها دسترسی داردPOST /v1/chat/completionsبرای چت و تولید متن؛ رایجترین مسیرPOST /v1/responsesقرارداد جدیدتر OpenAI که ابزارهایی مثل Codex از آن استفاده میکنند
Claude Code قرارداد خودش را دارد (Anthropic Messages با مسیر /v1/messages). پس درگاهی که میگوید با Claude Code کار میکند باید این قرارداد را هم بفهمد.
توکن، واحد هزینه
سرویسهای هوش مصنوعی ابری هزینه را بر اساس توکن حساب میکنند. توکن تکهای از متن است؛ طبق راهنمای خود OpenAI، در متن انگلیسی هر توکن حدود چهار کاراکتر است و متن فارسی برای همان مقدار معنا معمولاً توکن بیشتری مصرف میکند. توکن ورودی (prompt) و خروجی (پاسخ) جدا حساب میشوند و خروجی معمولاً نرخ بالاتری دارد. فیلد usage در هر پاسخ میگوید چند توکن رفت و چند توکن برگشت. همین عدد را لاگ کن تا آخر ماه بدانی اعتبار کجا مصرف شده.
کی به یک API متمرکز هوش مصنوعی نیاز داری؟
اگر یک اسکریپت شخصی داری که روزی ده درخواست میفرستد، یک حساب مستقیم کافی است. وضعیت وقتی عوض میشود که یکی از این موقعیتها برایت آشنا باشد:
- چند مدل از چند سازنده لازم داری؛ مثلاً یک مدل ارزان برای دستهبندی تیکتها و یک مدل قویتر برای تولید کد.
- چند نفر در تیم با ابزارهای مختلف کار میکنند: یکی Claude Code، یکی Cline در VS Code، یکی n8n برای اتوماسیون.
- میخواهی بدانی هزینه ماه گذشته مال کدام سرویس یا کدام نفر بوده است.
- وقتی کسی از تیم میرود، باید فقط کلید همان نفر را لغو کنی و بقیه بیدردسر به کارشان ادامه بدهند.
- کارت اعتباری خارجی نداری و میخواهی اعتبار را ریالی شارژ کنی، نه اینکه محصولت به حساب شخصی یک دوست در خارج از کشور بند باشد.
درگاه متمرکز برای مدلها همان کاری را میکند که API Gateway برای میکروسرویسها: یک ورودی واحد، احراز هویت یکجا، محدودیت نرخ و لاگ مرکزی. اگر با این الگو آشنا نیستی، API Gateway چیست؟ را ببین.
برای agentها سقف مصرف مهمتر هم میشود. یک AI Agent برای انجام یک کار ممکن است دهها درخواست پشت سر هم بفرستد. بدون سقف مصرف روی کلید، یک حلقه خراب میتواند اعتبار یک ماه را در یک شب تمام کند. نحوه میزبانی خود agent را در اجرای AI Agent روی سرور نوشتهایم.
مقایسه سرور اختصاصی هوش مصنوعی، API مستقیم و هوش مصنوعی ابری متمرکز
سه راه اصلی برای اضافه کردن مدل زبانی به محصول وجود دارد. جدول زیر آنها را از نگاه یک تیم کوچک نرمافزاری کنار هم میگذارد.
| معیار | مدل متنباز روی سرور اختصاصی هوش مصنوعی | API مستقیم هر سازنده | API متمرکز هوش مصنوعی ابری |
|---|---|---|---|
| هزینه شروع | اجاره یا خرید GPU، حتی وقتی ترافیک نداری | نزدیک صفر؛ پرداخت به ازای توکن | نزدیک صفر؛ پرداخت به ازای توکن |
| پرداخت از ایران | ریالی، اگر سرور داخلی بگیری | کارت اعتباری خارجی لازم است | بسته به سرویسدهنده؛ در چابکان پرداخت ریالی |
| تنوع مدل | فقط مدلهایی که خودت نصب کنی | فقط مدلهای همان شرکت | چند سازنده پشت یک کلید |
| کیفیت مدل | مدلهای open-weight مثل Llama، Qwen و DeepSeek | مدلهای روز همان شرکت | مدلهای روز چند شرکت |
| نگهداری | درایور، CUDA، سرور inference و مانیتورینگ با خودت | تقریباً هیچ | تقریباً هیچ |
| کنترل داده | کامل؛ داده از سرورت بیرون نمیرود | داده به سرور سازنده میرود | داده از درگاه به سازنده مدل میرود |
| عوض کردن مدل | دانلود و بارگذاری مدل جدید روی GPU | تغییر SDK اگر شرکت عوض شود | فقط تغییر رشته model |
| مناسب برای | داده حساس، حجم بالا و یکنواخت | کار با مدلهای یک شرکت خاص | تیمهای چندابزاره و محصول در حال رشد |
اجرای مدل روی سرور خودت وقتی منطقی است که داده نباید از شبکهات خارج شود یا حجم درخواستها آنقدر بالا و یکنواخت باشد که GPU همیشه مشغول بماند. معماری این مسیر را در سرور هوش مصنوعی چیست؟ توضیح دادهایم. اگر قابلیت AI تازه به محصولت اضافه شده و روزی چند صد درخواست داری، GPU اجارهای بیشتر روز بیکار میماند و پرداخت به ازای توکن در هوش مصنوعی ابری ارزانتر تمام میشود.
نکتههای توسعهدهنده ایرانی: دسترسی، پرداخت و تاخیر
دسترسی و پرداخت
برای API مستقیم OpenAI، Anthropic و Google معمولاً برای هر کدام یک حساب و کارت اعتباری خارجی لازم است. در درگاه هوش مصنوعی ابری چابکان با یک حساب و یک کلید به مدلهای چند سازنده دسترسی داری و اعتبار را با پرداخت ریالی و بدون کارت اعتباری خارجی شارژ میکنی. اگر محصولت به مدل زبانی وابسته است، این را هم در نظر بگیر که برای مشکلها بتوانی تیکت بزنی و فاکتور بگیری.
سقف مصرف
قبل از انتشار برای هر کلید سقف مصرف ماهانه بگذار. بدون سقف، یک باگ در حلقهٔ retry مصرف را چند برابر میکند. اگر سقف پر شود، درگاه به جای ادامهٔ مصرف خطای 402 برمیگرداند.
تاخیر یا latency
هر درگاه هوش مصنوعی ابری یک hop به مسیر اضافه میکند: برنامه تو، بعد درگاه، بعد سرور سازنده مدل و برگشت. معمولاً زمانی که خود مدل صرف تولید پاسخ میکند، از چند صد میلیثانیه تا چند ثانیه، از این hop بیشتر است. با این حال به عدد کلی اعتماد نکن و روی prompt واقعی خودت اندازه بگیر. صدک ۹۵ (p95) را نگاه کن، نه فقط میانگین را. در رابط کاربری streaming را روشن کن تا کاربر از همان توکن اول متن را ببیند.
حریم خصوصی داده
هر متنی که در prompt به سرویس هوش مصنوعی ابری میفرستی از زیرساخت تو خارج میشود. کد ملی، شماره کارت، رمز عبور و کلیدهای API را قبل از ارسال حذف یا ماسک کن. در لاگهای خودت هم هدر Authorization را ثبت نکن.
مثال عملی: اتصال به API هوش مصنوعی ابری با curl
مثالها روی درگاه هوش مصنوعی چابکان نوشته شدهاند. چون قرارداد OpenAI-compatible است، با عوض کردن base_url و کلید روی هر سرویس سازگار دیگری هم اجرا میشوند. طبق مستندات چابکان، Base URL برای ابزارهای OpenAI-compatible آدرس https://ai.chabokan.net/v1 است. کلید را از زبانه «کلیدهای API» در پنل سرویس بساز و شناسه مدل را از زبانه «مدلهای قابل استفاده» بردار.
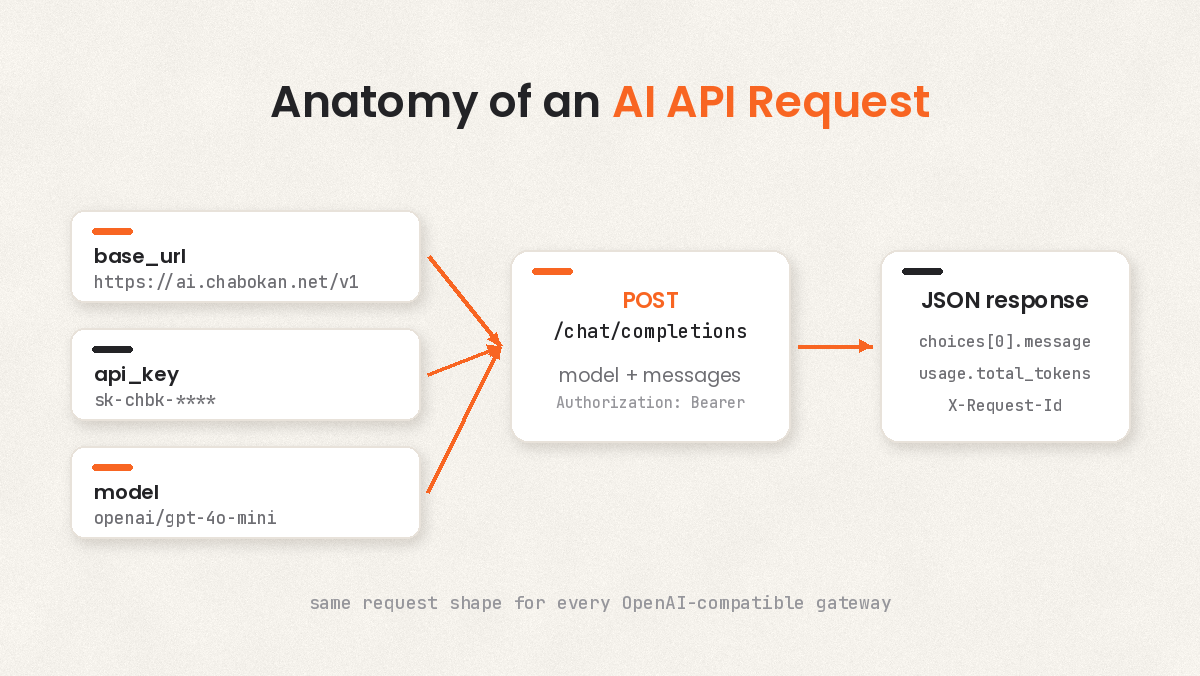
کوتاهترین آزمایش یک درخواست چت با curl است. کلید را در متغیر محیطی ترمینال بگذار، نه داخل سورس کد:
export CHABOKAN_AI_API_KEY="sk-chbk-your-key-here"

curl --fail-with-body https://ai.chabokan.net/v1/chat/completions \
  -H "Authorization: Bearer $CHABOKAN_AI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-4o-mini",
    "messages": [
      {"role": "system", "content": "You are a concise assistant. Reply in Persian."},
      {"role": "user", "content": "Explain what an API gateway does in two sentences."}
    ]
  }'
پاسخ یک JSON است. متن جواب در choices[0].message.content و مصرف در usage قرار دارد. پیام system رفتار کلی مدل را تعیین میکند و پیام user سؤال واقعی است. برای مکالمه چندمرحلهای، پیامهای قبلی را با نقشهای user و assistant به همین آرایه اضافه میکنی.
برای امتحان مدل دیگری از همان درگاه فقط مقدار model را عوض کن. طبق مستندات چابکان، مدلهای Gemini هم با همین قالب و با شناسهای که با google/ شروع میشود فراخوانی میشوند، اما endpoint بومی Gemini یعنی generateContent روی این درگاه ارائه نمیشود.
ساختن سرویس و کلید، گرفتن فهرست مدلها و همین درخواست با SDK رسمی پایتون و Node.js و با PowerShell را قدم به قدم در آموزش کار با API ChatGPT و ساخت کلید آوردهایم.
هوش مصنوعی ابری چابکان
چابکان سرویس هوش مصنوعی ابری را به شکل یک درگاه واحد ارائه میدهد. این موارد در صفحه محصول و مستندات آن آمده است:
- API سازگار با OpenAI (Chat Completions و Responses) روی
https://ai.chabokan.net/v1و قرارداد Anthropic Messages برای Claude Code رویhttps://ai.chabokan.net - دسترسی به مدلهای متنی و تصویری چند سازنده با یک کلید و بدون ثبتنام جداگانه در هر سرویس
- کلید API جدا برای هر ابزار یا محیط، با تاریخ انقضا و سقف مصرف ماهانهٔ اختیاری؛ کلید با
sk-chbk-شروع میشود و فقط یک بار نمایش داده میشود - بخش «چت با مدل» در صفحهٔ سرویس برای تست بدون کد و زبانه «گزارش درخواستها» با لاگ کامل به تفکیک مدل
- پلنها در سطح دسترسی به مدلها و سقف درخواست در دقیقه با هم فرق دارند
- هزینه مصرف مدل جدا از هزینه پلن است و اعتبار مدل را از کیف پول حسابت شارژ میکنی که با پرداخت ریالی پر میشود
مستندات چابکان برای ابزارهای رایج راهنمای جدا دارد: Claude Code، Codex، Cline، Continue، Roo Code، Aider، OpenCode، Open WebUI، n8n و LangChain. پشتیبانی Cursor طبق همان مستندات محدود و وابسته به نسخه است. برای امتحان، از صفحه هوش مصنوعی ابری چابکان یک سرویس بساز، دستور curl بالا را اجرا کن و مصرفش را در گزارش درخواستها ببین. با اعتبار هدیهٔ ۱۰۰ هزار تومانی میتوانی مصرف هوش مصنوعی را تست کنی.
اشتباههای رایج در کار با API هوش مصنوعی
- گذاشتن کلید در کد فرانتاند یا اپ موبایل. هر کسی که DevTools را باز کند کلید را میبیند. درخواست را از backend خودت بفرست.
- یک کلید برای همه چیز. کلید لپتاپ، CI و production را جدا کن تا لغو یکی بقیه را از کار نیندازد.
- اسم نمایشی به جای Model ID. عنوانی که در پنل یا سایت سازنده میبینی با شناسهای مثل
openai/gpt-4o-miniیکی نیست. - تکرار
/v1. اگرbase_urlرا با/v1تنظیم کردهای و دستی هم/v1/chat/completionsاضافه کنی، خطای 404 میگیری. در Claude Code آدرس را بدون/v1بنویس. - retry روی همه خطاها. خطای 400 و 401 با تکرار درست نمیشود؛ فقط 429 و 5xx را با backoff و تعداد محدود دوباره امتحان کن.
- فرستادن کل سند در هر درخواست. context بزرگ هم کند است هم گران. برای پاسخ بر اساس اسناد خودت، الگوی RAG در هوش مصنوعی را پیاده کن تا فقط بخشهای مرتبط به مدل برسد.
- لاگ کردن prompt کامل. اگر prompt اطلاعات کاربر دارد، فقط متادیتا را نگه دار: مدل، latency، توکن و status code.
کد وضعیت پاسخ معمولاً جای مشکل را نشان میدهد: 401 یعنی کلید نرسیده یا نامعتبر است، 402 یعنی اعتبار یا سقف ماهانهٔ کلید تمام شده، 404 یعنی مسیر یا شناسهٔ مدل اشتباه است و 429 یعنی از سقف درخواست در دقیقه رد شدهای. متن دقیق خطاها و راه رفع هرکدام در بخش «خطاهای رایج» مقالهٔ آموزش کار با API ChatGPT و ساخت کلید آمده است. برای خطاهای 5xx مقدار هدر X-Request-Id را نگه دار تا پشتیبانی بتواند درخواست را پیدا کند.
سوالات متداول درباره هوش مصنوعی ابری
هوش مصنوعی ابری با سرور هوش مصنوعی چه فرقی دارد؟
در سرور هوش مصنوعی، GPU و مدل در اختیار خودت است و نگهداریاش هم با خودت. در هوش مصنوعی ابری فقط به API دسترسی داری و سرویسدهنده زیرساخت را اداره میکند. اولی کنترل بیشتری روی داده میدهد و دومی شروع سریعتر و هزینه متغیر.
دادهای که به هوش مصنوعی ابری میفرستم کجا میرود؟
متن prompt از زیرساخت تو خارج میشود، به درگاه میرسد و از آنجا به سرور سازندهٔ مدل میرود. برای همین کد ملی، شماره کارت، رمز عبور و کلیدها را قبل از ارسال حذف یا ماسک کن و اگر داده نباید از سازمانت بیرون برود، سرور اختصاصی هوش مصنوعی را بررسی کن.
آیا هوش مصنوعی ابری رایگان است؟
بستگی به سرویس دارد. در چابکان پلن پایه هزینه پلن ندارد و مدلهای محدودی، از جمله openai/gpt-4o-mini، در اختیارت میگذارد، اما مصرف مدل از اعتبار شارژشده کسر میشود.
برای ساختن کلید و فرستادن اولین درخواست از کجا شروع کنم؟
از پنل چابکان یک سرویس هوش مصنوعی بساز، اعتبار را از کیف پول شارژ کن و اول در بخش «چت با مدل» یک پیام آزمایشی بفرست. بعد در زبانهٔ «کلیدهای API» کلید بگیر. مراحل کامل، با تست curl، پایتون، Node.js و PowerShell، در آموزش کار با API ChatGPT و ساخت کلید آمده است.
درگاه هوش مصنوعی ابری پاسخ را کندتر میکند؟
درگاه یک مرحله به مسیر درخواست اضافه میکند، اما معمولاً زمانی که خود مدل صرف تولید پاسخ میکند بیشتر است. روی prompt واقعی خودت اندازه بگیر و در رابط کاربری streaming را روشن کن تا کاربر متن را از همان توکن اول ببیند.
چطور هزینه را قبل از راهاندازی تخمین بزنم؟
ده تا بیست درخواست واقعی بفرست و میانگین prompt_tokens و completion_tokens را از usage بردار. آن را در نرخ مصرف همان مدل و بعد در تعداد درخواست روزانهای که انتظارش را داری ضرب کن. یک حاشیه هم برای retry و پیامهای طولانیتر کنار بگذار.