
هر چند ماه یک مدل تازه میآید و همه میگویند «این دیگر بهترین است». اگر برنامهنویس باشی، سؤال واقعیات این است: برای همین پروژهای که روی میزم است، کدام مدل کمتر خرابکاری میکند و کمتر وقتم را میگیرد؟ این راهنما دنبال جواب همین سؤال است. بهترین هوش مصنوعی برای برنامه نویسی را بر اساس نوع کار، اندازهٔ کدبیس و جایی که کدت باید بماند مقایسه میکنیم، نه بر اساس هیاهوی معرفیها.
اسم مدلها و توضیح هر کدام را از صفحههای رسمی Anthropic، OpenAI، Google و DeepSeek و صفحهٔ مدلها در Hugging Face برداشتهایم (آبان ۱۴۰۵). این فهرست زود کهنه میشود، پس روش انتخاب را جدیتر از اسمها بگیر.
بهترین هوش مصنوعی برای برنامه نویسی را با چه معیاری بسنجیم؟
جدولهای بنچمارک عدد خوبی برای شروع هستند. مثلاً SWE-bench میسنجد مدل چقدر میتواند یک issue واقعی گیتهاب را حل کند. ولی پروژهٔ تو با آن مخزنها فرق دارد. این پنج معیار در کار روزمره بیشتر به چشم میآیند:
- ابزارخوانی (tool calling). وقتی مدل را داخل Claude Code، Cline یا Cursor میگذاری، باید فایل بخواند، دستور اجرا کند و خروجی را بفهمد. مدلی که فقط چت خوبی دارد در این حالت وسط کار گم میشود.
- پنجرهٔ کانتکست. مدلهای پرچمدار امروز حدود یک میلیون توکن ورودی میگیرند. یعنی یک کدبیس متوسط یا چند هزار خط لاگ در یک درخواست جا میشود. هر چه کانتکست پرتر شود، هر درخواست کندتر و پرهزینهتر هم میشود.
- سرعت پاسخ. برای تکمیل خودکار کد، چند ثانیه تأخیر یعنی ابزار را خاموش میکنی. برای یک refactor بزرگ، چند دقیقه صبر مشکلی ندارد.
- هزینهٔ هر کار، نه هر درخواست. یک agent برای یک تسک ساده ممکن است دهها درخواست بفرستد. مدل ارزانتری که دو بار بیشتر تلاش میکند گاهی گرانتر درمیآید.
- جای نگهداری کد. اگر قرارداد یا سیاست شرکت اجازه نمیدهد کد از سرور خودتان بیرون برود، فقط مدلهای open-weight که خودت اجرا میکنی به درد میخورند.
مدلهای Claude؛ انتخاب پیشفرض برای کدنویسی با agent
Anthropic در صفحهٔ معرفی مدلها چهار مدل فعلی را اینطور معرفی میکند:
- Claude Opus 5.5: برای «کدنویسی agentic طولانی». خود Anthropic پیشنهاد میکند برای بیشتر کارها از همین شروع کنی.
- Claude Fable 5.1: برای استدلال سنگین و کارهای agent خیلی طولانی، وقتی Opus 5.5 کم آورد. کندتر از بقیه است.
- Claude Sonnet 5.5: تعادل سرعت و هوش. برای کار روزانه در ادیتور انتخاب منطقیای است.
- Claude Haiku 5.5: سریعترین مدل خانواده، برای طبقهبندی، استخراج و کارهای پرتعداد.
هر چهار مدل کانتکست یک میلیون توکنی دارند و تا ۱۲۸ هزار توکن خروجی میدهند. یعنی Opus میتواند یک patch بلند را یکجا بنویسد و وسطش قطع نشود. نقطهضعف Claude این است که هم کاربر ایرانی برای حساب مستقیم Anthropic به کارت خارجی نیاز دارد و هم مدلهای بالایش جزو گرانترهای بازارند. اگر با Claude Code کار میکنی، راهنمای Claude Code در ایران با API چابکان قدمبهقدم اتصالش را توضیح داده است.
مدلهای GPT از OpenAI
OpenAI در صفحهٔ مدلها نسل فعلی را با اسمهای تازهای چیده است:
- GPT-6 Astra: مدل پرچمدار «برای استدلال پیچیده و کدنویسی».
- GPT-6.1 Sol: عملکرد نزدیک به Astra با هزینهٔ کمتر.
- GPT-6.1 Terra: سریع، با تمرکز روی استدلال تصویری و کار با رابط کاربری.
- GPT-6 Luna: کمهزینهترین گزینه برای کارهای متمرکز و پرتعداد.
کانتکست این مدلها حدود ۱٫۰۵ میلیون توکن است و همه چند سطح reasoning دارند، از low تا max. برای سؤال ساده لازم نیست مدل را روی بیشترین سطح فکر کردن بگذاری. Terra برای کارهایی که مدل باید اسکرینشات UI یا طرح فیگما را ببیند و به کد تبدیل کند مناسب است.
اگر ابزارت Codex است، حواست باشد که Codex با Responses API کار میکند، نه Chat Completions. یعنی هر درگاهی بهطور پیشفرض با آن جور نیست. برای شروع کار با API، مقالهٔ آموزش کار با API ChatGPT را ببین.
Gemini؛ وقتی سرعت و کانتکست بزرگ مهم است
در فهرست مدلهای Gemini API، دو مدل برای برنامهنویس مهماند:
- Gemini 4 Argon: مدل استدلالی پرچمدار گوگل با کانتکست یک میلیون توکنی.
- Gemini 3.8 Flash: گوگل آن را «برای مهندسی نرمافزار طولانی و agentهای خودکار» معرفی کرده است. برای کسی که سرعت میخواهد و نمیخواهد سراغ مدل سنگین برود گزینهٔ خوبی است.
یک نکتهٔ عملی: گوگل دسترسی به خانوادهٔ Gemini 2.5 را به کاربرانی محدود کرده که قبلاً از آن استفاده کردهاند و برای پروژهٔ جدید 3.8 Flash یا 3.5 Flash-Lite را پیشنهاد میکند. اگر آموزشی قدیمی میگوید gemini-2.5-pro بگذار، اول ببین هنوز به آن دسترسی داری یا نه.
مدلهای متنباز؛ DeepSeek، Qwen و بقیه
مدل open-weight یعنی وزنهای مدل منتشر شده و میتوانی آن را روی سختافزار خودت اجرا کنی. چند گزینهٔ جدی امروز:
- DeepSeek V4.1 Flash و V4 Pro: وزنهایشان با مجوز MIT روی Hugging Face هست. API رسمی DeepSeek هم طبق مستندات خودش با فرمت OpenAI و Anthropic سازگار است و میشود آن را پشت Claude Code یا OpenCode گذاشت.
- Qwen: خانوادهٔ Qwen علیبابا هم مدلهای عمومی دارد (مثل Qwen3.8-27B با مجوز Apache-2.0) و هم سری مخصوص کد با اسم Qwen3-Coder.
- Kimi و GLM: Moonshot نسخهٔ Kimi-K2.7-Code را برای کد منتشر کرده و Zhipu هم GLM-5.3 را. مجوز هر دو «other» است، پس قبل از استفادهٔ تجاری متن مجوز را بخوان.
- gpt-oss: OpenAI هم دو مدل open-weight با مجوز Apache-2.0 دارد، gpt-oss-20b و gpt-oss-120b.
مزیت اصلی این مدلها کنترل است: داده از سرور تو بیرون نمیرود و قیمت هم دست ارائهدهندهٔ خارجی نیست. هزینهاش این است که مدلهای بزرگ برای اجرای خودی سختافزار سنگینی میخواهند و نگهداریشان کار خودت است. خیلی از تیمها همین مدلها را از طریق API مصرف میکنند و فقط مدلهای کوچک را خودشان بالا میآورند. اگر میخواهی بدانی LLM دقیقاً چطور کار میکند، مقالهٔ مدل زبانی بزرگ (LLM) چیست؟ را بخوان.
جدول مقایسهٔ خانوادهها
| خانواده | مدل برای کار سنگین | مدل برای کار روزانه | مدل سبک | وزنهای باز | نقطهضعف |
|---|---|---|---|---|---|
| Claude | Opus 5.5، Fable 5.1 | Sonnet 5.5 | Haiku 5.5 | ندارد | مدلهای بالا گراناند |
| GPT | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Luna | فقط gpt-oss | Codex فقط با Responses API |
| Gemini | Gemini 4 Argon | Gemini 3.8 Flash | 3.5 Flash-Lite | فقط Gemma | تغییر سریع نسخهها و محدودیت مدلهای قدیمی |
| DeepSeek | V4 Pro | V4.1 Flash | همان Flash | دارد (MIT) | اجرای خودی سختافزار سنگین میخواهد |
| Qwen | سری Max | Qwen3-Coder | مدلهای ۲۷B و کوچکتر | بیشتر مدلها (Apache-2.0) | کیفیت پاسخ فارسی را باید خودت تست کنی |
کدام مدل برای کدام کار؟
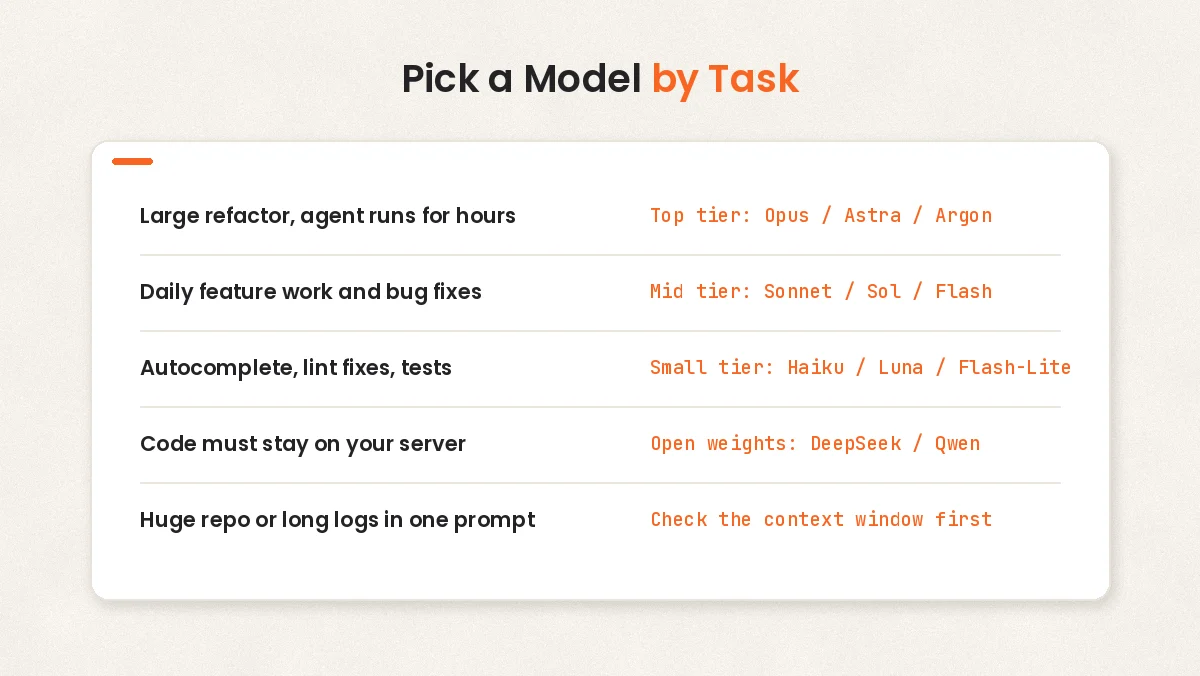
بهجای یک «بهترین» مطلق، این تقسیمبندی در عمل جواب میدهد:
- refactor بزرگ یا agentی که چند ساعت روی مخزن کار میکند: مدل ردهٔ بالا مثل Opus 5.5 یا GPT-6 Astra. اینجا هر اشتباه مدل یعنی چند ساعت بازبینی، پس صرفهجویی روی مدل معمولاً ضرر است.
- نوشتن فیچر و رفع باگ روزانه در ادیتور: ردهٔ میانی مثل Sonnet 5.5، GPT-6.1 Sol یا Gemini 3.8 Flash. سریعاند و برای بیشتر تسکها کافیاند.
- تکمیل خودکار، نوشتن تست، رفع خطای lint: مدل سبک مثل Haiku 5.5 یا GPT-6 Luna. اینجا سرعت از هوش مهمتر است.
- کدی که نباید از سرور بیرون برود: DeepSeek یا Qwen روی سرور خودتان.
- ساخت سایت با ابزارهای وایب کدینگ: معمولاً ابزار مدل را خودش انتخاب میکند. اگر تازه شروع کردهای، وایب کدینگ چیست؟ را بخوان و برای ابزارهای کدنویسی هم ۵ ابزار هوش مصنوعی برای کدنویسی و دیباگ را ببین.
بهترین راه انتخاب یک آزمایش کوچک است. دو یا سه مدل را روی یک تسک واقعی از پروژهٔ خودت امتحان کن: خواندن ساختار مخزن، یک tool call فقطخواندنی و نوشتن یک patch کوچک. زمان، تعداد توکن و تعداد دفعاتی که مجبور شدی دستی درستش کنی را یادداشت کن. یک ساعت آزمایش بیشتر از ده جدول بنچمارک به کارت میآید.
چطور چند مدل را با یک کلید امتحان کنیم؟
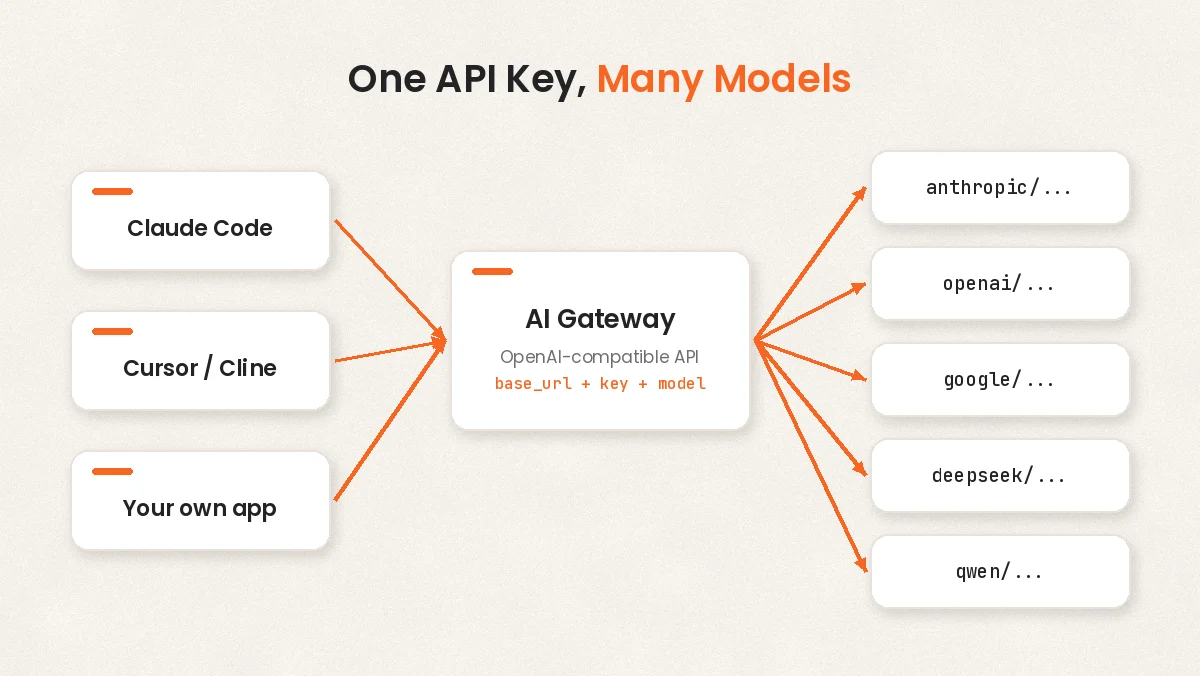
ساختن حساب جدا در Anthropic، OpenAI و Google برای کاربر ایرانی یعنی سه بار دردسر کارت خارجی و سه داشبورد صورتحساب. راه سادهتر یک درگاه (gateway) سازگار با OpenAI است که همهٔ مدلها را پشت یک آدرس و یک کلید میگذارد. در این حالت عوض کردن مدل فقط یعنی عوض کردن یک رشته:
from openai import OpenAI

client = OpenAI(
    base_url="https://ai.chabokan.net/v1",
    api_key="sk-chbk-your-key",
)

for model in ["anthropic/claude-sonnet-5.5", "openai/gpt-6.1-sol", "deepseek/deepseek-v4-pro"]:
    reply = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Write a Python function that validates an IBAN."}],
    )
    print(model, "->", reply.choices[0].message.content[:200])
شناسهٔ دقیق هر مدل را از زبانهٔ «مدلهای قابل استفاده» در پنل یا از مسیر /v1/models بگیر، چون اسم نمایشی مدل با شناسهاش یکی نیست. راهنمای انتخاب مدل در مستندات چابکان معیارهای بیشتری برای این آزمایش دارد.
هوش مصنوعی ابری چابکان برای این آزمایش
هوش مصنوعی ابری چابکان همین درگاه را در اختیارت میگذارد: یک API سازگار با OpenAI، کلید جدا برای هر دستگاه، لاگ درخواستها به تفکیک مدل و پرداخت ریالی. مدلهای Claude، GPT، Gemini، DeepSeek، Qwen، Kimi و GLM هر کدام صفحهٔ جدا دارند و فهرست کامل مدلها و تعرفهها هم در جدول همان صفحههاست. برای شروع میتوانی از اعتبار هدیهٔ ۱۰۰ هزار تومانی چابکان برای مصرف مدلها استفاده کنی.
چند محدودیت را هم بدان. چابکان مدلها را از سازندهها میگیرد و خودش مدل نمیسازد، پس اگر سازندهای مدلی را بازنشسته کند، اینجا هم میرود. بعضی مدلها هم فقط در پلنهای بالاتر در دسترساند. اگر پروژهای که با کمک AI ساختهای آماده شد، مقالهٔ آنلاین کردن پروژهٔ ChatGPT یا Claude مسیر انتشارش روی هاست را توضیح داده است.
سؤالات متداول
بهترین هوش مصنوعی برای برنامه نویسی کدام است؟
یک جواب ثابت ندارد. برای کار agentic طولانی، مدلهای ردهٔ بالا مثل Claude Opus 5.5 یا GPT-6 Astra قویترند. برای کار روزانه، Sonnet 5.5 یا Gemini 3.8 Flash سریعتر و بهصرفهترند. اگر کد باید روی سرور خودت بماند، DeepSeek و Qwen گزینههای open-weight جدیاند.
برای برنامهنویسی، مدل رایگان هم به درد میخورد؟
برای یادگیری و کارهای کوچک بله. مدلهای open-weight مثل gpt-oss-20b یا Qwen در اندازههای کوچک روی سختافزار معمولی هم اجرا میشوند. ولی برای agentی که چند ده فایل را با هم تغییر میدهد، فاصلهٔ کیفیت با مدلهای ردهٔ بالا محسوس است.
کانتکست یک میلیون توکنی یعنی کل پروژهام را بفرستم؟
میتوانی، ولی کار خوبی نیست. هر توکن ورودی هزینه دارد و پاسخ را کندتر میکند. ابزارهایی مثل Claude Code فقط فایلهای مرتبط را میخوانند. کانتکست بزرگ وقتی به کار میآید که واقعاً باید چند هزار خط لاگ یا یک ماژول بزرگ را یکجا ببینی.
آیا میتوانم در Cursor یا Cline از مدل دلخواه استفاده کنم؟
بیشتر این ابزارها اجازه میدهند Base URL و کلید سفارشی بدهی. کافی است درگاهت با پروتکل ابزار سازگار باشد. Claude Code از Messages API استفاده میکند، Codex از Responses API و بیشتر ابزارها از Chat Completions. برای جزئیات بیشتر، MCP چیست؟ هم توضیح میدهد ابزارها چطور به مدل وصل میشوند.
چرا مدلی که در آموزش آمده برای من کار نمیکند؟
یا مدل بازنشسته شده، یا دسترسیاش محدود شده، یا شناسه را اشتباه وارد کردهای. مثلاً گوگل Gemini 2.5 را فقط برای کاربران قبلی باز گذاشته است. همیشه شناسه را از فهرست مدلهای همان سرویس کپی کن.